万卡集群的老登与新贵
全球能提供 GPU 算力租赁的云厂商已经超过五十家。AWS 和 Azure 在数据中心基础设施上砸了二十年,但在万卡 GPU 训练集群这个局部战场上,抢下头部大模型订单的反倒是成立不到五年的算力新贵。这不是偶然,是结构性的代差。
全球能提供 GPU 算力租赁的云厂商已经超过五十家。AWS 和 Azure 在数据中心基础设施上砸了二十年,但在万卡 GPU 训练集群这个局部战场上,抢下头部大模型订单的反倒是成立不到五年的算力新贵。这不是偶然,是结构性的代差。
一、老登为什么打不过
以太网是第一道坎。AWS 在 GPU 集群上主推自研弹性网络适配器 EFA,底层依然是以太网协议,跨节点实测带宽约 101 GB/s。专业 GPU 云走 InfiniBand,跨节点带宽 750 GB/s,差了七倍多。
万卡训练跑数据并行、流水线并行和张量并行混合切分,每个前向和反向传播步骤结束,上万张 GPU 要做 All-Reduce 同步梯度。通信时间就是集群的心跳速度。101 GB/s 的心跳喂不饱 Blackwell,一旦数据包丢失触发拥塞控制,几千张显卡集体挂起空转。
虚拟化是第二道坎。传统云在硬件和操作系统之间插了一层管理程序,用于多租户切分和安全隔离,不可避免地带来中断抖动。万卡训练要求网络拓扑高度确定,任何一块网卡的微小抖动都会沿着通信拓扑放大到整个集群。对老牌大厂来说,剥掉虚拟化等于否定自己二十年的软件资产,做不到。
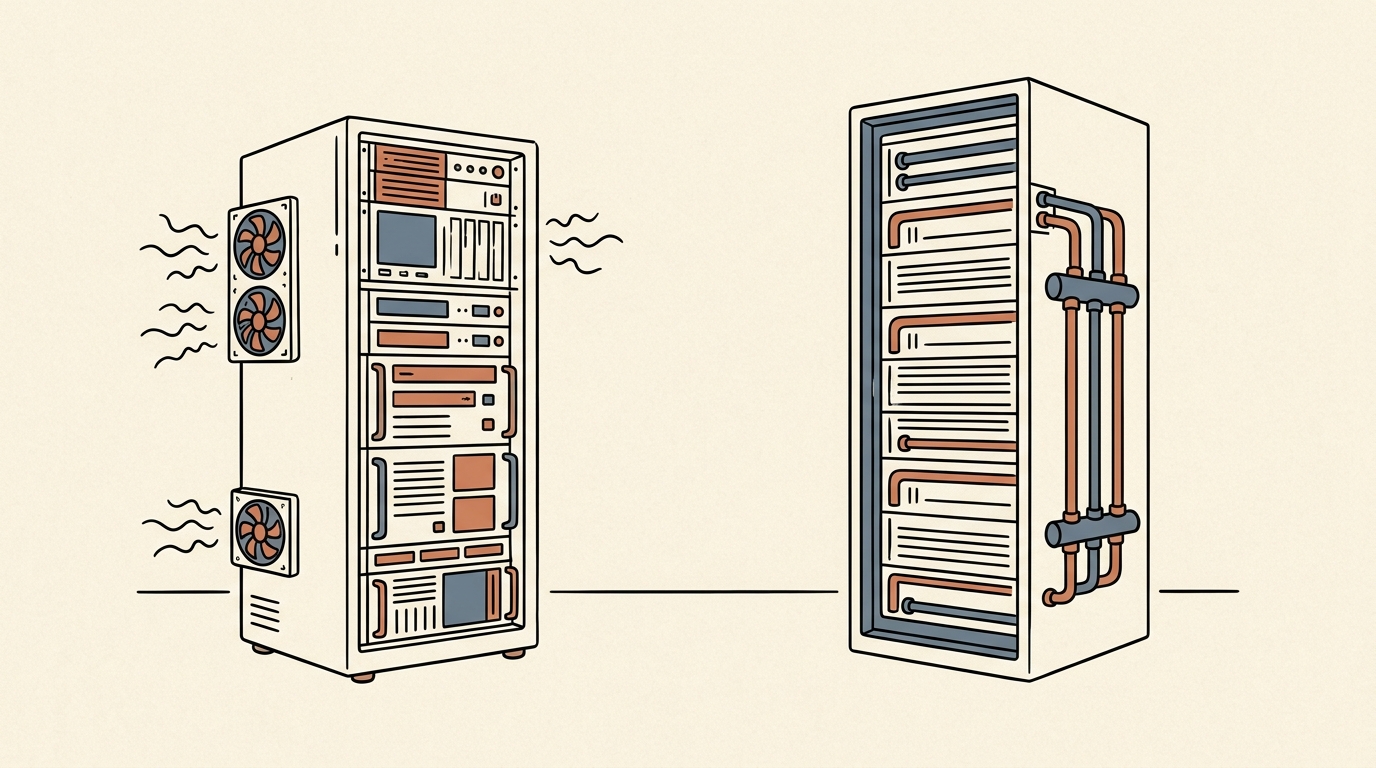
液冷改造是第三道坎。老牌大厂的存量数据中心大多为风冷设计,单机柜维持在 10 到 20 kW。最新的 GB300 NVL72 整柜系统将 72 张计算卡整合进单一机柜,功率超过 130 kW,强制液冷。存量机房要接这种整柜,得重铺冷却液管路、升级到 480V 高压供电,改造成本和停机风险极高,妥协和拖延是必然结果。
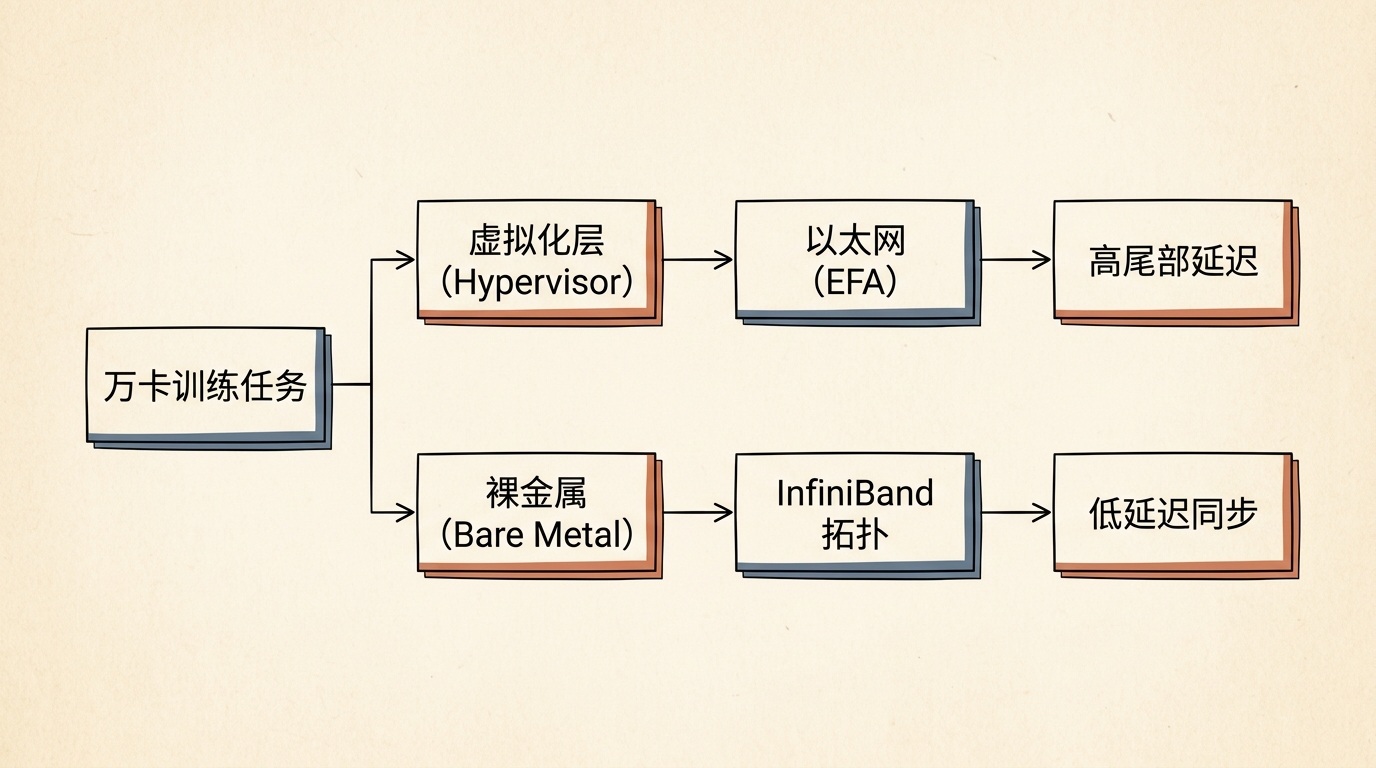 通用公有云与专业算力云的万卡训练数据流对比。上方虚拟化与以太网路径面临尾部延迟,下方裸金属与专用网络实现确定性同步。
二、新贵凭什么赢
新贵没有历史遗留资产,机房从选址到配电全部围绕 GPU 单一负载设计,工程交付密度直接拉到老牌大厂追不上的水平。
CoreWeave 每周上架上万张 GPU。自研集群生命周期控制器 FLCC,从通电自检、固件烧录到网络校验全流程自动化。万卡训练中常见的故障往往表现为某张卡慢下来拖全局步频,而非显卡直接脱机,CoreWeave 在监控层直接抓取 NCCL 遥测数据定位问题卡号,不用客户自己翻日志做二分查找。定制了可编程液冷阀组 Valvey,每个机柜冷却回路独立调节,异常时几秒内切断局部管路。
Nebius 在 2025 年 12 月完成了 HGX B300 集群上线,比多数公有云大厂早了半年以上。开源调度框架 Soperator 解决了容器化训练环境下的文件可见性冲突,被多家外部算力运营商直接拿去用。
财务模型的差异同样关键。CoreWeave 通过抵押硬件承担了约 350 亿美元债务,重度依赖大客户的多年期长约,锁死了算力涨价周期的弹性利润。Nebius 推行全额预付加动态竞价,客户先付钱再上机,几乎没有应收账款风险,资本回报率维持在极高区间。英伟达向 Nebius 注资 20 亿美元并持股 9.3%,在硬件配给上给予倾斜,2027 年底前签约电力目标 5 GW。
当 CoreWeave 率先完成下一代 Vera Rubin VR200 系统的深层工程验证,英伟达用脚投票的逻辑就很清楚,优先把新卡给工程能力最强的合作伙伴,体量大小反而靠后。
三、老登还能追上来吗
留给老牌大厂补课的窗口期其实非常窄。
从过去的八卡 HGX 服务器过渡到 NVL72 整柜系统,是一场涉及整个数据中心物理形态的彻底重构。计算核心换成 ARM 架构的 Grace 芯片、机柜强制引入直接液冷、单柜负荷跃升到 130 kW 高压供电、网络升级为五轨 800G 拓扑、配套软件栈也得从底层重写,有任何一块短板都会导致机柜无法上线。传统数据中心如果想把旧风冷机房改造成高密度液冷机房,工程窗口只有一到两年,错过这一波硬件交付节奏就会直接在预训练市场掉队。
越过 NVL72 这道工程断崖之后,从 Blackwell 到下一代 Vera Rubin 并不会推倒重来。两代产品共享相似的机柜尺寸、供电规格、冷却接口与网络架构。率先把 NVL72 跑通的新贵,建好的机房与运维体系能够无缝接纳下一代芯片。先发优势一旦在物理基建层面固化,后来者连弯道超车的机会都很难找到。
老牌大厂追赶困难,场上的新贵也并非高枕无忧。在专业算力云内部,淘汰同样毫不留情。一批缺乏底层工程能力、靠转售算力和概念包装推高估值的中间商,正在被市场迅速挤出。大模型研发团队借助 AI 编程工具自己搞定集群运维,过去托管软件层附带的两三倍溢价正在被快速抹平,裸金属重新成为主流交付形式。
当软件层的管理溢价被逐渐压薄,算力产业的利润重心重新沉回到了物理世界。不管最终哪家云厂商能够站稳脚跟,上万张计算芯片跑完全流程,都必须依靠密集的 800G 光模块、高可靠的液冷阀组与分配单元、承载兆瓦级冲击的高压配电系统,以及握在手里的电力与场地指标。这场万卡竞赛最后的赢家,依然属于给留在场上的所有人供铲子的人。