AI4S 大模型吃不掉的创业机会
很多人以为,用 AI 设计新材料和研发药物(AI4S,AI for Science)这个新兴的 AI 研究方向,很快又会被科技巨头彻底垄断。
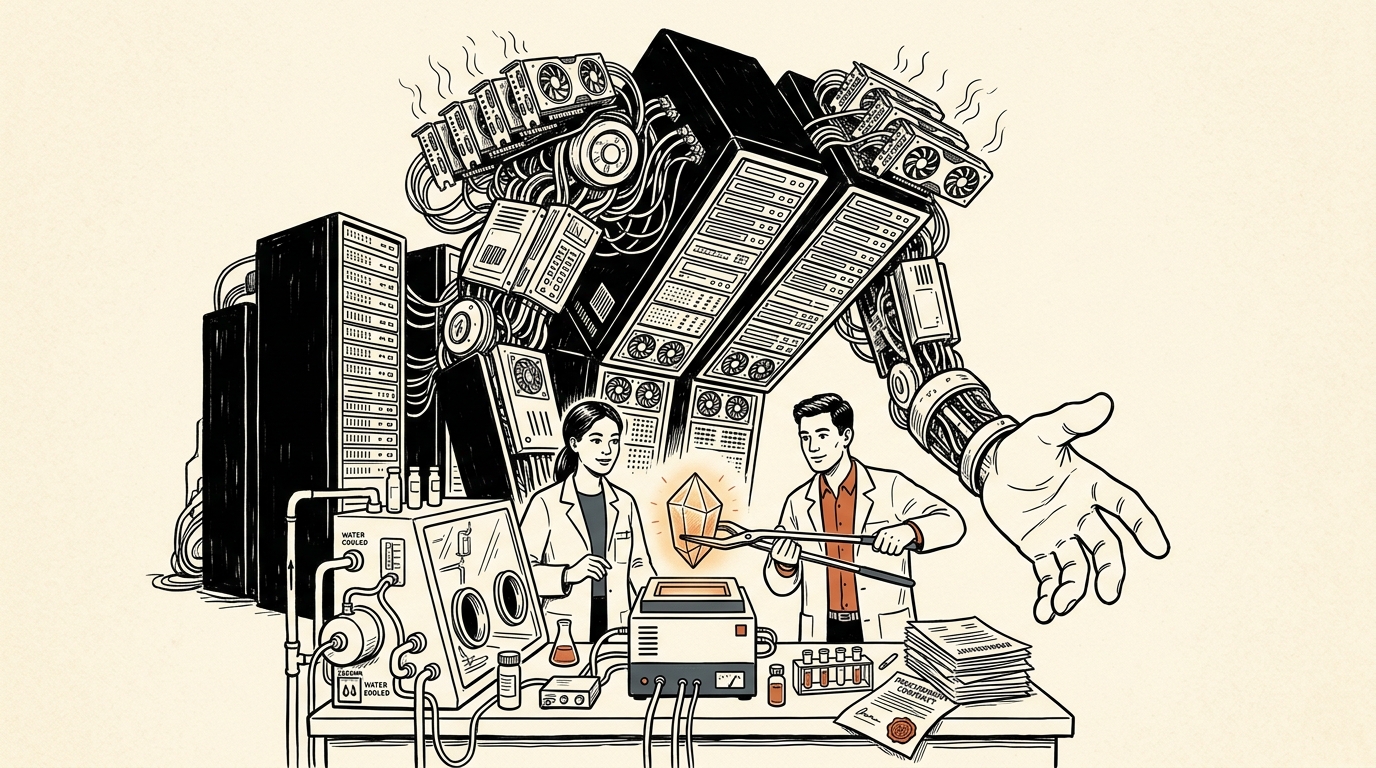
很多人以为,用 AI 设计新材料和研发药物(AI4S,AI for Science)这个新兴的 AI 研究方向,很快又会被科技巨头彻底垄断。
因为在普遍的直觉里,大厂有的是计算卡与资本,只要像做 大语言模型 那样把算力堆到极致,训出一个能预测一切原子与分子行为的科学版通用大模型,初创团队根本没有还手之力。
但现实现实情况是,大语言模型制造垄断的那几股力量,一旦进入真实的物理世界里,全都在反向给创业团队送装备。
通用模型吞不掉物理世界
大语言模型之所以能够横扫垂类模型,依赖三个前提。
一,自然语言属于单一模态与统一目标,万物皆可预测下一个词。 二,训练语料靠全网爬虫抓取,边际成本接近零。 三,用户对容错要求不高,偶发幻觉可通过产品交互掩盖。
物理世界把这三条全堵死了。
非单一模态与多目标:原子势能面、电子态密度、吸收光谱、合成工艺配方,每一项背后都是完全不相容的物理场。哪怕是当下最强的 UMA,也仅仅统一了原子尺度这一小截切片。涉及强关联体系、激发态、核量子效应、连续介质力学,各自都有不可压缩的物理法则,没有任何单一模型能一口吞下。
数据稀缺:科学数据必须一次次实打实算出来,或者在手套箱与通风橱里测出来。催化剂表面积碳失活、固态电解质界面晶界退化、连续化反应釜放大良率,这些数据在密度泛函方程里算不出来,砸钱买显卡同样买不到。
超低容错率:工业决策的物理约束极度苛刻。化学精度约为每摩尔 1 千卡,折合 43 毫电子伏。通用模型在基准集上的能量误差通常在 20 到 30 毫电子伏每原子,但相稳定性判断的窗口往往只有 25 到 50 毫电子伏。区区 20 毫电子伏偏差足以把一张材料相图完全判反。语言模型出错是回答不自然,原子模拟出错会在动力学轨迹里发生虚假排斥或非物理熔化。用户投几十万做实验,钱花光了才发现材料根本合不成。
行业格局最终只会收敛于少数开源基础模型加上大量垂直领域的微调适配,再连通下游的物理实验验证。
数据垄断失效:大厂算不完物理世界
大语言模型建立护城河,靠的是把全网数十万亿字语料暴力压缩进模型,本质就是强行把 OOD 数据包含在训练分布内,再把优质数据和前沿权重一律锁死。
科学计算完全反过来了。Meta 烧掉六十六亿核心时算出一亿多次密度泛函单点(OMol25),连同剑桥的 MACE、自己的 UMA 权重全部开源。大厂不靠势函数赚钱,只把模拟工具做成免费基建来推自己的接口标准与芯片。创业团队等于白拿了几千万美元的起跑线。
但这会引来新的担忧,大厂算力无限,会不会最终像抓取网页一样,把整个物理空间算完,建立终极数据垄断?
答案是不会。化学空间的可能构型在十的六十次方以上。人类数百年积累的晶体只有几十万种,大厂算上亿个点,在物理宇宙尺度下覆盖率依然是数学上的零测度。
而且大语言模型和 AI4S 的商业价值方向彻底倒置。语言模型的商业价值在常见分布(in distribution)内,越贴近大众通用习惯越好卖。AI4S的价值全部在未探索的分布外区域。用模型筛出数据库里已有的已知晶体数据一文不值,有商业价值的全是从未合成过的全新组分、非平衡过渡态与极端工况相。
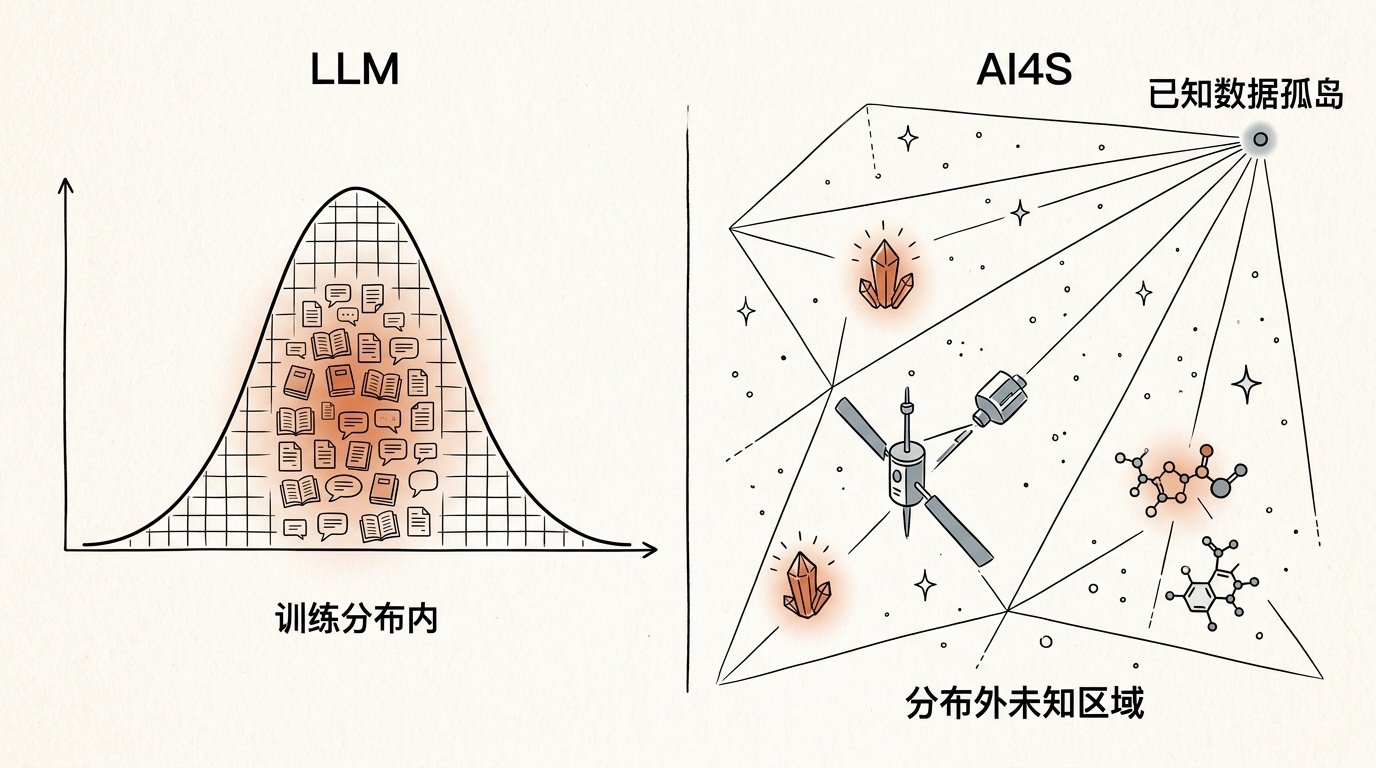
公版基础模型充其量是一份基于近平衡构型的粗糙地图。面对注定无法穷尽的物理空间,通用模型永远不可能把世界塞进训练集。
所以,创业团队的核心竞争壁垒是建立一套深入未知物理区域的勘探系统,包含不确定度筛选、高风险构型采样与单点标定。通用模型越强大,这套勘探系统的运行成本反而越低。
算力垄断失效:五十人团队叫板科技巨头
大语言模型的算力高墙之所以坚不可摧,是因为语言模态缺乏物理先验,只能靠万卡集群堆砌参数,通过规模法则暴力涌现智能。初创团队没有数万张计算卡,毫无还手之力。
科学智能把这条算力杠杆直接折断了。
严格的物理先验可以直接折抵海量算力与参数。分子与晶体天然遵循三维空间旋转等变性与原子体序对称性。把这些物理几何定律直接硬编码进网络架构,依靠的是数学理论洞察,而非算力堆叠。一个几百万参数的等变几何模型,往往能轻松击败用海量算力硬训出来的几亿参数普通模型。
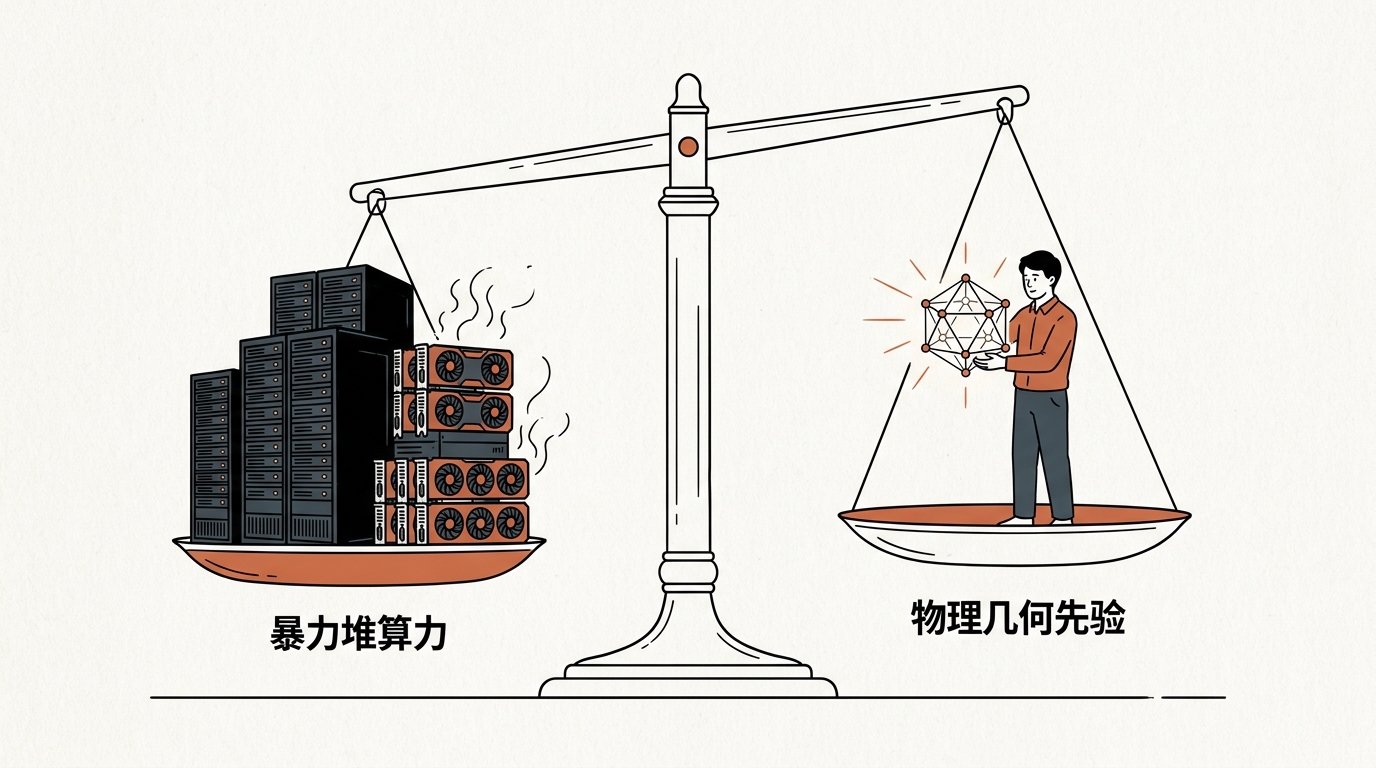
过去五年原子深度学习的核心架构,从 SchNet、NequIP、Allegro 到 MACE、SevenNet,全部由高校实验室发明并开源。Orbital Materials,全公司只有五十人,研发的 ORB 模型却长年在权威榜单 Matbench Discovery 上稳居前列,正面迎战 Meta。在语言大模型领域,全世界找不出任何一家五十人小公司能在主榜上叫板科技巨头;而在科学计算领域,小团队凭借精妙的物理先验,就能完全抵消掉巨头的万卡算力鸿沟。
大厂深知自己的物理局限。它们免费开源算法,因为它们本身就是全球最大的物理基础设施采购方。解决算力中心散热与电力的下一代浸没式冷却液、高导热均热板,巨头与其自己算,不如直接向创业团队采购。而创业公司做科技巨头的工业材料供应商,也远比跟大厂死磕模型参数更有商业前景。
胜负手根本不在三要素里
算力、算法、数据:决定通用大语言模型与多模态大模型生死的绝对核心要素。在科学智能领域彻底失灵了。开源大潮早已把基础势函数、上亿次单点数据和等变几何架构打成了免费公共设施。光在虚拟环境里把模型跑出漂亮指标,根本换不来一张真实的工业采购订单。
AI4S 的竞争壁垒由此发生了根本性分化,清晰地裂变为上下两层。
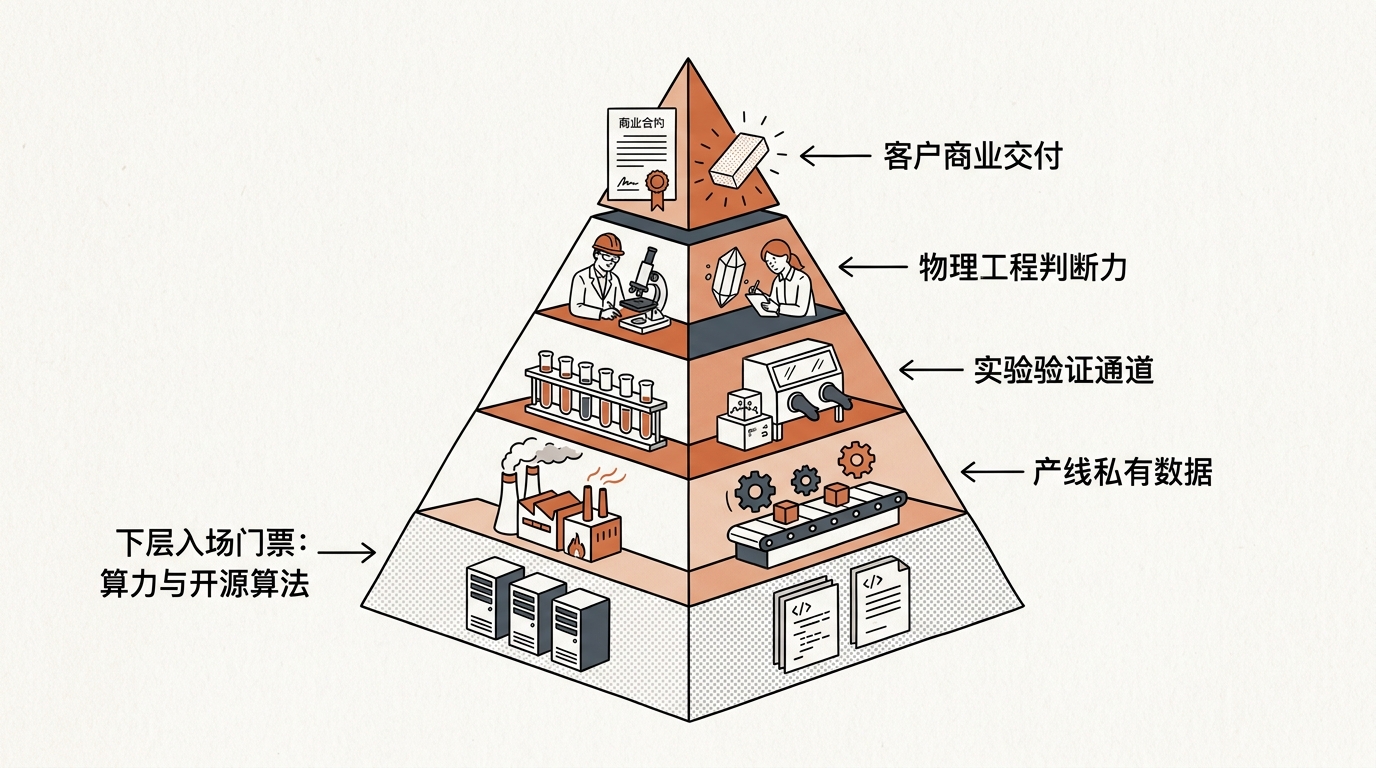
下层 已经被开源压平的入场门票
- 算力与工程算法 跟紧开源社区即可。开源权重免费、单次推理极其便宜,几十美元就能调用。只要不盲目从零训练通用大模型,算力在科学计算中几乎不构成阻击对手的成本壁垒。
上层 软件无法替代的四大真壁垒
-
第一壁垒 实验验证通道(最核心的效率差) 从软件筛选出候选结构,到湿实验室拿出真实样品、测出关键物性的转化周期与试错成本。验证周期按月算还是按天算,决定了整个研发迭代的生死时速。
-
第二壁垒 商业场景与客户验证周期(时间壁垒) 选对痛点极深、愿意支付高溢价的下游工业客户。传统材料工业的采购验证周期长达十八到三十六个月,谁先跑通合作范例并拿到量产订单,谁就建立起同行需要耗费数年才能追赶的商业时间差。
-
第三壁垒 产线级私有数据(真正的独家资产) 完全独立于密度泛函计算之外的真实物理数据。包括极端工况下的老化失效记录、合成工艺窗口、杂质容忍度与产线放大良率。这些数据在算力服务器里算不出来,只能在实体车间里一点点累积出来。
-
第四壁垒 物理与工程判断力(避坑能力) 深厚的领域物理直觉。能在模型给出漂亮的虚拟能量指标时,一眼识破动力学假象与计算陷阱,避免把宝贵的实验预算浪费在根本无法合成的假结构上。
通用大模型拼的是虚拟生成能力的上限,AI4S 拼的是穿越物理摩擦的真实交付能力。
科学基础模型会把表征层集中在少数开源系统手中,但绝不会让工业应用层变空。创业团队的核心护城河从来不在显卡和参数规模里。谁能在开源大模型与工业客户之间,把那段不可自动化的真实样品、工艺参数与产线验证打磨成自己的专有资产,谁就拥有了科技巨头吃不掉的位置。