AI 急缺湿实验?
写代码有编译器,敲下回车一毫秒内就能报错输出;围棋有清晰胜负规则,算力自我博弈就能进化。
写代码有编译器,敲下回车一毫秒内就能报错输出;围棋有清晰胜负规则,算力自我博弈就能进化。
但生命科学没有数字编译器,自然界唯一的编译器是真实的生化反应。AlphaFold预测了上亿个静态蛋白质结构,可一旦脱离湿实验的物理反馈,AI模型既测不准分子活性,也推不出活体毒性,动辄出现数量级偏差。
当AI设计药物分子的边际成本压到了接近于零,生物医药产业链的稀缺要素的上中下游被彻底重构。
一、 上游数据重构,私有失败记录成了硬通货
公开蛋白质数据库只有二十多万个结构,早被大模型反复清洗训练。更棘手的是学术发表的幸存者偏差,期刊论文里九成五以上全是做成功的阳性结果。只用这套公开数据训练,开源模型几个月内就能抹平差距。若拿模拟数据自我反哺,模型概率分布会迅速退化,把生化反应里的罕见致命毒性彻底抹平。
真正能帮算法解决数据稀缺问题,是包含完整实验过程的私有阴性数据。哪种溶剂配比会导致沉淀,什么温度会让靶点蛋白失活变性,算法必须拿到精确的失败记录才能建立因果关联,走出毫无休止的结构幻觉。Recursion每周做数百万次显微表型检测,百图生科自建高通量实验平台,核心目的都是为了给算法生产外界拿不到的失败数据。
其次是未经药物处理的原代患者组织样本。针对常见靶点做分子修饰已无空间,寻找全新疾病机制必须深入真实人体的单细胞时空多组学组织切片。受制于伦理审批与获取难度,这种第一手生理资产花钱买不来,算法更不可能凭算力凭空推导出来。
二、 中游产能堵塞,自动化工站与实验猴成为物理瓶颈
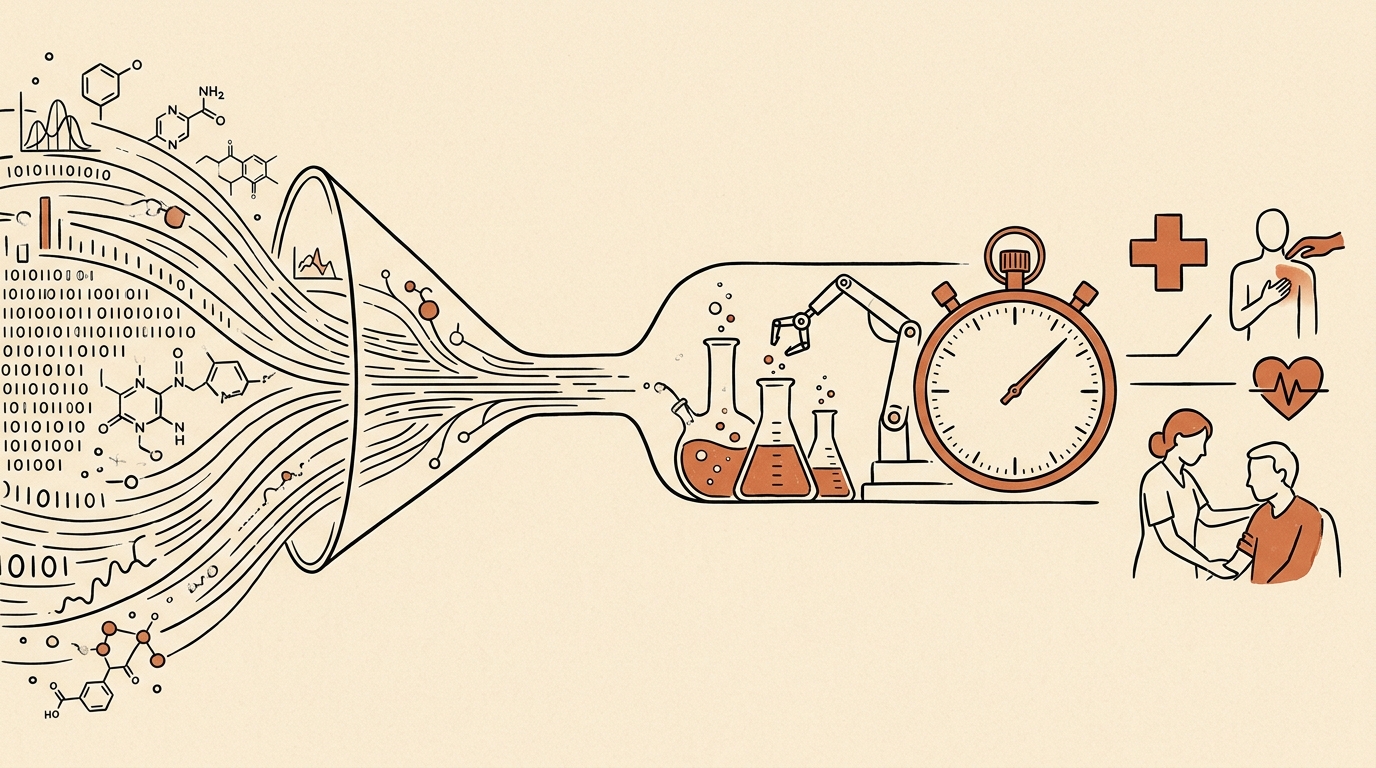
分子预测出来,必须要完成极其密集的物理验证。
第一道卡口是从代码到物质的物理转化。AI 大模型吐出来的只是一串数字序列,要变成真实物质,必须先做基因合成。算法每天生成海量未知抗体与蛋白质序列,超过三成都是在金斯瑞的平台上下单合成 DNA 质粒,将虚拟代码打印成物理实体。
实体合成出来之后,紧接着撞上体外反应的生物标尺。算法生成的分子到底能不能结合靶点,需要在试管里与真实蛋白发生生化反应。针对极其复杂的全长膜蛋白与前沿靶点,百普赛斯通过纳米盘技术保留天然构象,义翘神州则依靠数万种重组蛋白现货货架随时响应突发验证。如果这两家企业提供的基准靶标折叠错误或存在批间漂移,湿实验测出的亲和力数据就会失真,反向给 AI 模型投毒。
即便有了高保真靶标,人工移液每天处理的批次依然有限且误差大。从确定靶点到挑出候选分子,算法把过去的四到六年压缩到十二至十八个月,这逼得晶泰部署两百多个机器人工作站全天候运转,直接把湿实验做成高通量代工厂,承接井喷的合成验证需求。
但比体外测试更严苛的物理卡点,在活体动物的安全性评价。
候选药物进临床前,法规要求必须在哺乳动物体内完成系统毒理学评价。大分子抗体和复杂新药对生理特征贴近人类的食蟹猴依赖极重。算力几个月就能翻倍,但食蟹猴长到实验规格必须老老实实走完六到七年的生理生长周期。生物常数无法靠加算力压缩。
供需断裂直接反映在采购成本上。2026年随着海量分子堆积到安评环节,国内适龄食蟹猴采购单价从上一轮周期低点强劲反弹,公开中标价普遍达到十七八万元,优质适龄猴甚至突破二十万元。拥有充足存栏猴储备的昭衍、药明康德等安评机构,实验排期直接排到了大半年之后。
为了绕开漫长的动物周期,行业开始转向微流控人体器官芯片。在FDA通过现代化法案允许微生理系统数据用于申报后,能够模拟人体肝脏毒性的微流控芯片需求骤增。不过微流控芯片的高一致性量产依然受制于微纳制造产能,短期内难以填补巨大的安评缺口。
三、 下游临床阻隔,人体代谢节律锁死研发周期
即便顺利通过合成与动物实验,候选分子跨入人体临床阶段,数字世界的速度优势也会彻底归零。
药物在人体内的吸收代谢、肿瘤响应与长期毒性随访,起步就需要几个月甚至一两年。生理节律不可加速,而当各家团队用相似算法筛选同一批热门靶点,患者招募立刻演变为零和博弈。符合特定基因突变且没有耐药史的病人群体是恒定的,超过八成临床试验都卡在患者入组延期。泰格、艾昆纬掌握的医院网络与研究病床,构成了绕不开的物理渠道。
而且二三期临床实验的单人次花费没有任何降低,推进一条药物管线依然需要数千万元到数亿元的真金白银。最终药物能否跨越临床审批并实现放量变现,考验的是云顶新耀这类企业在临床注册、医保准入与重资产商业化团队上的硬功夫。缺乏下游临床兑现能力的轻资产算法公司,只会在海量分子的内卷中迅速贬值。
结论
AI没有消灭新药研发的物理门槛,全行业的研发成本完整转移到了物理验证环节。
当算法把分子生成的边际成本压向零点,产业链的超额利润,加速流向受制于细胞生长周期和人体生理时钟的物理环节。