Engram:AI 还缺哪种存储?
The body of this note is currently in Chinese.
2026 年 9 月,DeepSeek 在开源模型 DeepSeek-V4.1-Flash 中引入了 Engram 架构,把近 200GB 的模型参数搬出了显存。
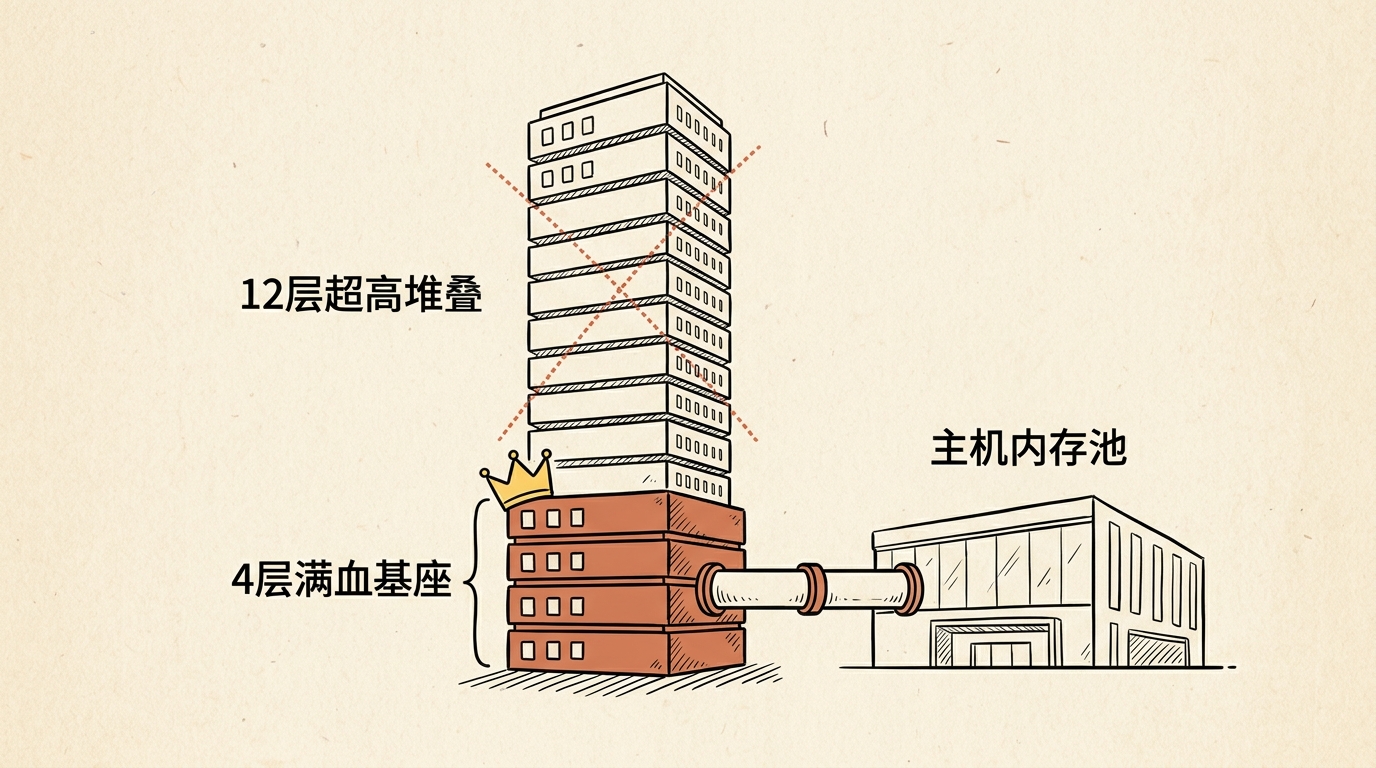
2026 年 9 月,DeepSeek 在开源模型 DeepSeek-V4.1-Flash 中引入了 Engram 架构,把近 200GB 的模型参数搬出了显存。几天后,英伟达被爆料,因为 HBM 晶圆和先进封装产能吃紧, Rubin Ultra 的显存从 288GB 砍到 192GB,
算法在主动缩减显存需求,供应链在被动压缩显存供给,高层数大容量 HBM 开始退烧。
一、Engram 把 200G 赶出显存
大模型运行中处理两类任务。一类是高维逻辑推理,遇到复杂逻辑和多步推导时,依赖多头注意力和专家网络层层推演;另一类是固定模式记忆,遇到高频词组、实体名词或样板代码时,本质上是在提取先验特征。
以往这两部分参数全部塞在 HBM 显存中。DeepSeek 的 Engram 将两者解耦,把计算留在显存,把静态记忆卸载到主板普通内存。
具体实现上,Engram 建立了一张海量 N-gram 哈希查找表。表内包含 196.6B 个参数,在 FP8 精度下占用 188.8GB,常驻于主板 DDR5 内存中。
Engram 在整个推理流中负责提供辅助特征,最终预测词依然由 Transformer 独立生成。它的作用是在网络计算流中插入一段查表得到的记忆特征向量。
以预测句子“美国的首都是____”为例。模型接收到输入文本后,Engram 截取局部的连续词元“(美国,的,首都,是)”,通过哈希函数计算出索引,直接从大表中调出一个训练好的嵌入向量。这个向量并非文本单词“华盛顿”,它承载着当前词组对后续预测有帮助的先验特征。
模型不设置分类器去区分记忆题还是推理题,这段外挂特征的调用程度由门控单元动态决定。门控计算当前隐藏状态与查表向量的相似度,输出一个零到一之间的连续权重。如果语境高度契合,权重接近一,特征向量便注入隐藏状态,辅助后续的注意力层与专家网络轻松完成预测。如果语境不符,权重接近零,查表结果被自动忽略。面对复杂的数学应用题时,Engram 依然正常查表,但门控仅提取基础词义,多步数值运算依然由 Transformer 的深层网络独立完成。
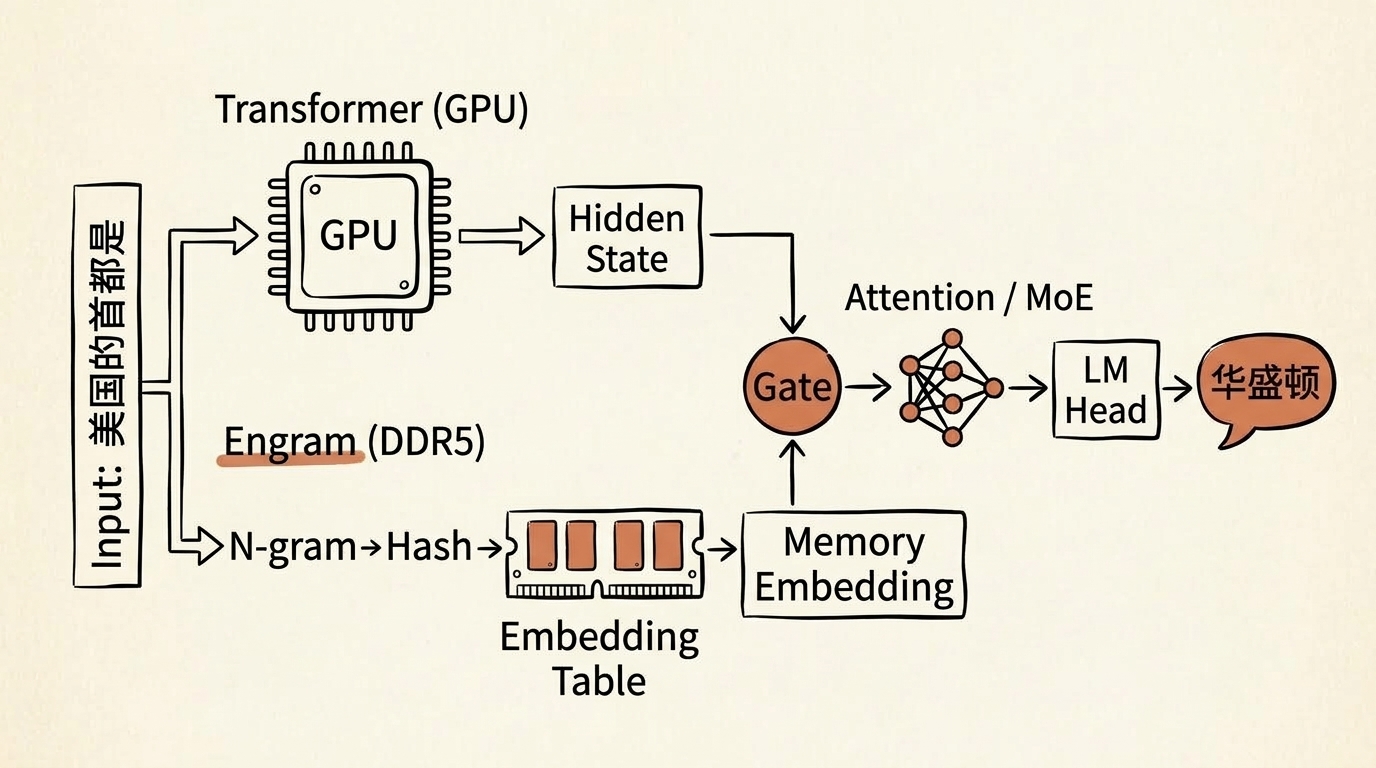 图示呈现了 Engram 的双轨计算流程。GPU 负责上下文的高维推理,DDR5 负责局部词元的哈希查表,门控单元动态融合两路特征,最终依然由输出层预测下一个词。
主板 DDR5 内存的带宽远低于 HBM,但查表能够做到零等待,核心原因在于预取时机。由于查表索引仅由输入的词元决定,完全独立于前几层的深度计算,因此在 GPU 刚刚计算第一层输入嵌入时,CPU 便已通过 PCIe 总线将后续所需的查表向量提前搬运至显存。等计算流水线抵达 Engram 层,数据已在显存中就绪,整体前向推理没有产生停顿。
二、4 层 HBM 就够了
200GB 参数挪到普通内存之后,HBM 不再需要大容量。这时候看 HBM 芯片的物理结构,有一笔账很多人没算过。
HBM 是把多层 DRAM 芯片垂直堆叠、用铜柱(TSV)打通数据通路。但 HBM4 规范把底座到 GPU 的总数据接口定死在 2048 位,单层芯片最多接出 512 位。4 层×512 = 2048,刚好占满全部接口,峰值带宽 3328 GB/s。
继续堆到 8 层、12 层,显存容量变大了,但底座接口没变,上面的层只能轮流共用通道,峰值带宽一个字节都不会增加。
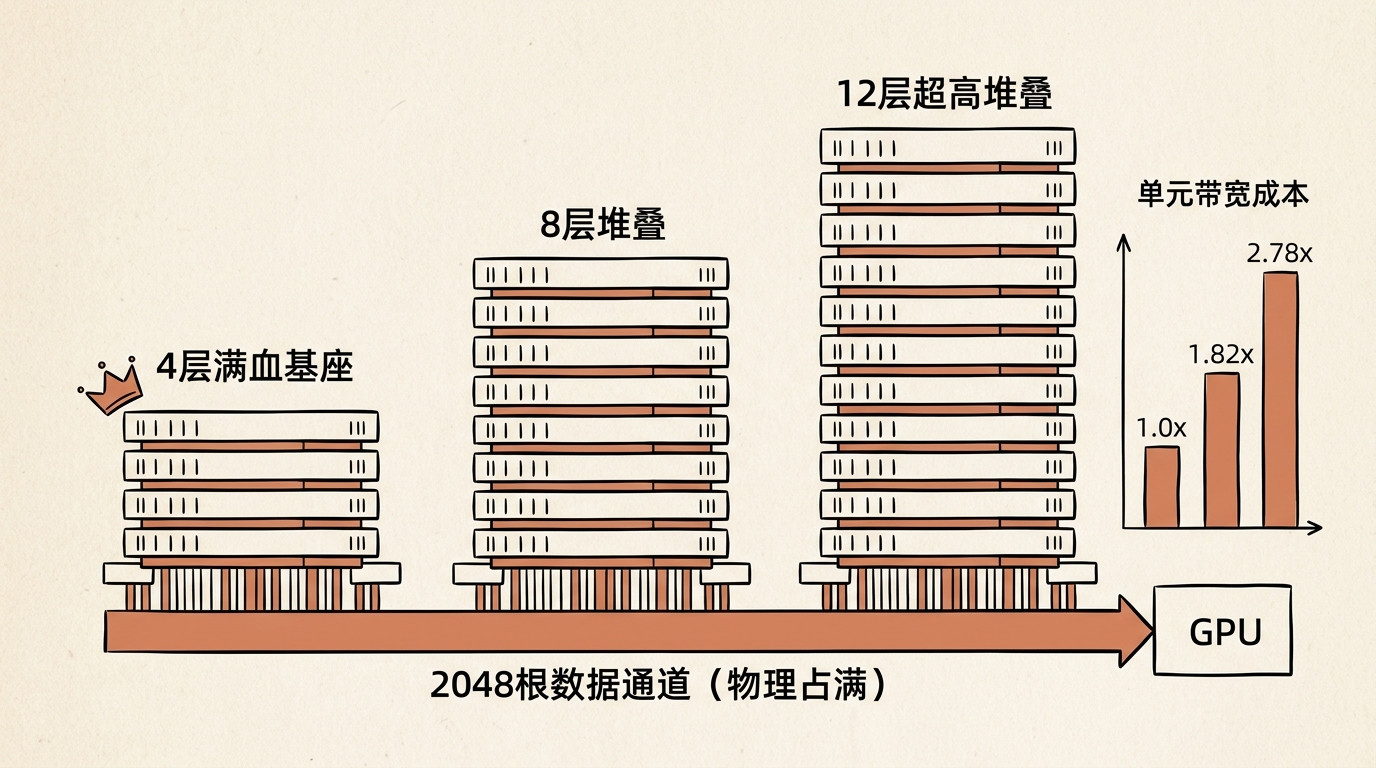
单位带宽成本,以 4 层为基准,8 层贵 1.82 倍,12 层贵 2.78 倍。多出来的钱全花在了容量上,带宽没多一个字节。
在模型进入下半场,需要大容量的预训练从 2024 年初占 67% 的算力,跌到 2026 年底预计只剩 7%。剩下 93% 全是推理和强化学习,推理阶段每生成一个 Token 都要全速读一遍参数,瓶颈在带宽,容量反而过剩。
Engram 进一步释放了容量压力,推理又只认带宽,4 层 HBM 就是性价比最高的配置。Rubin Ultra 因供应链压力降配,反而暗合了这条趋势。
三、内存赚爆,硬盘撞墙
200GB 参数搬出显存之后放到哪里?主板内存(DRAM)和固态硬盘(SSD)单价都远低于 HBM,但实测结果差别极大。
把 188.8GB 查表权重卸载到 DDR5 内存后,GPU 显存要背的负担瞬间大减。以前跑这种大模型,单卡或双卡显存装不下,必须用张量并行把模型硬拆到 4 块 GPU 上(TP4),卡间频繁同步数据,通信延迟吃掉了大量算力。现在模型变轻了,英伟达 B300 服务器直接把并行度从 4 卡降到 2 卡(TP2)。跨卡通信开销砍掉一半以上,端到端吞吐反超了 1.6 到 1.76 倍,同时显存还富余出大量空间来承接并发交互缓存(KV Cache)。
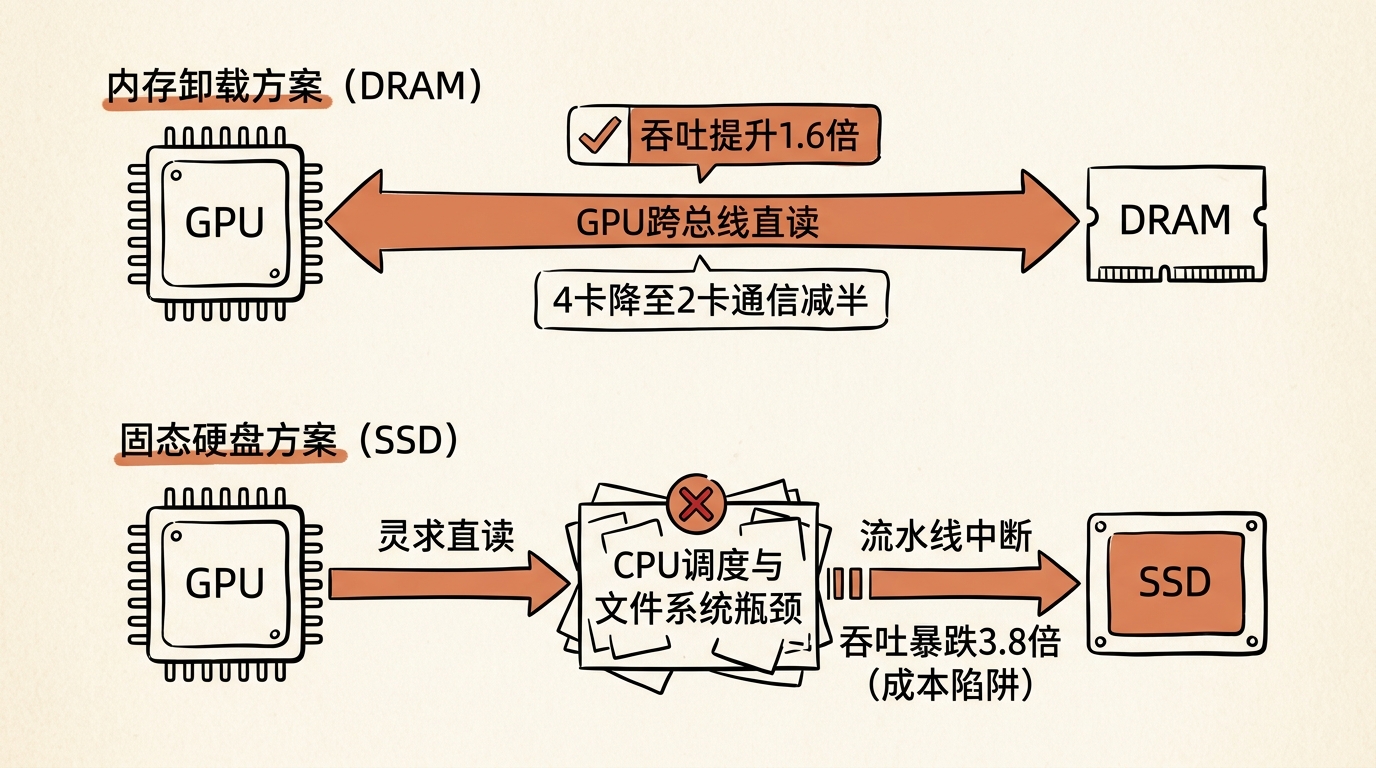
但如果参数放进 SSD硬盘,GPU 和 CPU 一颗没省,而SSD 要走操作系统文件缓存,CPU 反复介入搬数据,GPU 频繁停工等待。吞吐量落后 DRAM 方案 3.84 倍,每美元产出的 Token 跌了 57%。在线推理场景下,SSD 行不通。
四、四大存储巨头的牌局变了
当采购逻辑从高层大容量 HBM 转向 4 层 HBM + 大容量 DDR5 内存,四家存储原厂各自受到的影响不一样。
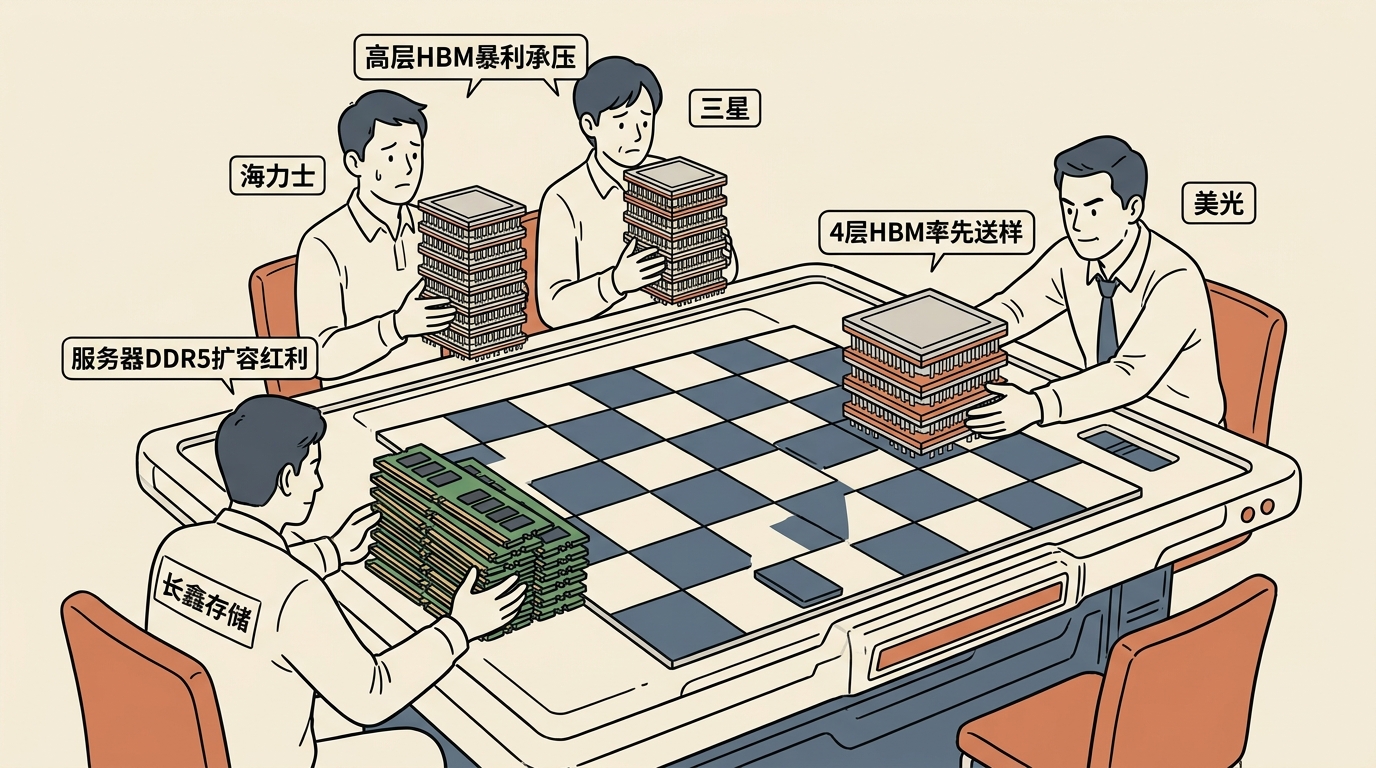
SK 海力士与三星。这两家过去两年靠高层 HBM 赚得最多,8 层、12 层制造复杂,成倍消耗晶圆产能,同时卖垄断高价。转向 4 层意味着每颗 HBM 用的晶圆面积只剩几分之一,营收直接缩水。两家对 4 层方案态度消极,市场推演认为最终会折中,原厂对 4 层加收约 10% 的容量溢价平摊底部逻辑芯片成本,双方各退一步。
美光。在 8 层和 12 层的良率竞争中一直落后。4 层方案一出,美光率先响应,已经给至少两家大客户送样 4-hi HBM。低堆叠避开了高层封装的良率难题,交期也更快。
长鑫存储。受制裁影响,HBM 完全做不了。但 Engram 让每台 AI 服务器的 DDR5 内存配置从 256GB 起步拉到 512GB 甚至 1TB 以上。DDR5 不需要 EUV 光刻机,正好是长鑫这几年主攻的方向。制程、产能和数据中心验证的硬仗还在前头,但需求确实来了。
五、Engram 的能力边界,五菱宏光跑不了 F1
Engram 这么好,为什么 OpenAI 的 o 系列和 Anthropic 的 Claude 旗舰模型不用?看用了 Engram的模型名字就知道了。DeepSeek-V4.1-Flash,Qwen 3.8 Flash Next,都带 Flash 后缀,定位是跑量而非冲顶。
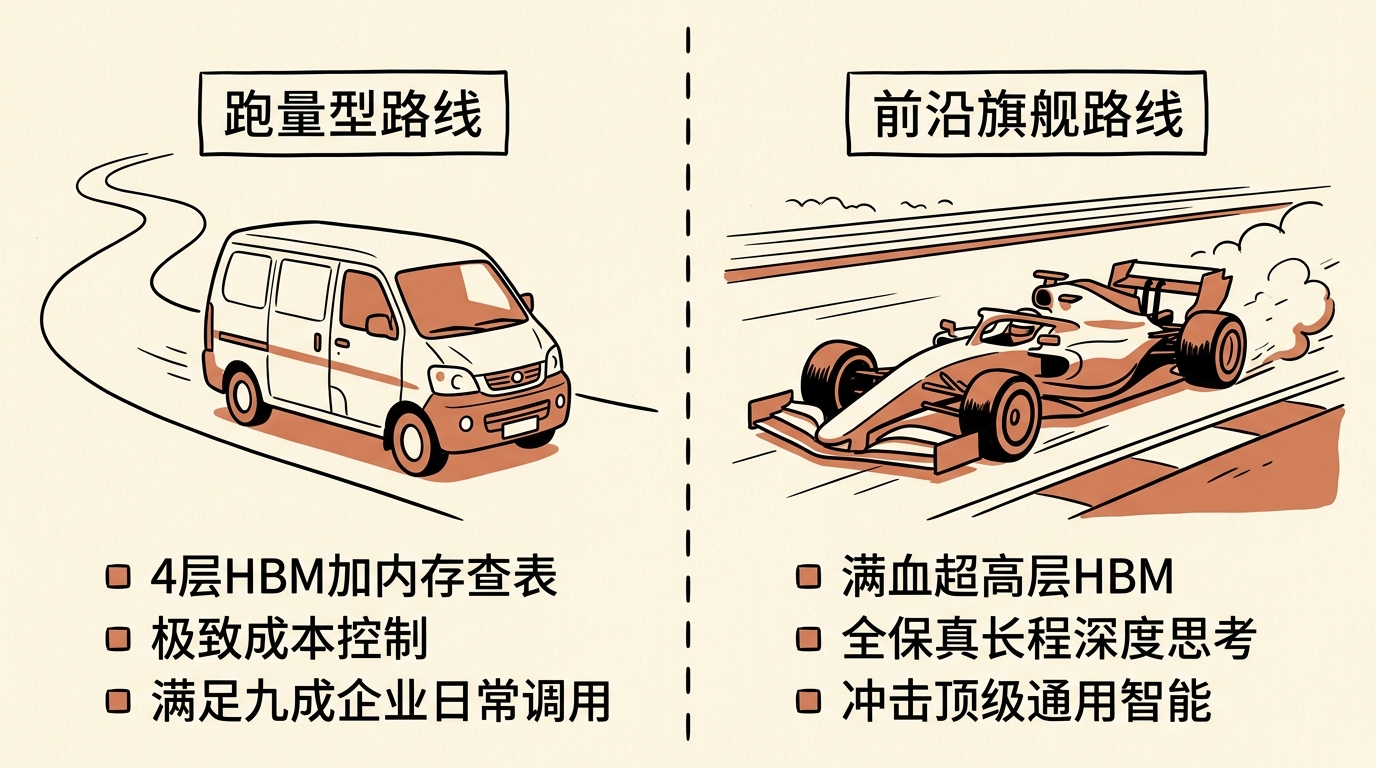
Engram 存的是高频文本模式、实体名词、样板代码,本质是一个查找表,不会给模型增加推理能力。DeepSeek 在 Flash 系列中还把 KV Cache 压缩了 75%,普通问答没问题,但长程推理场景下压缩带来的信息损失会逐步累积。
所以 AI 工业正在明确分流。旗舰模型保留全精度网络与满配显存,不惜成本冲刺智能上限,充当探索未知的 F1 赛车。跑量模型用 Engram 卸载静态记忆、把显存压到 4 层、把推理成本砸进地板,通吃九成以上的日常调用,充当普及技术的五菱宏光。
算法对存储的重构甚至会倒逼芯片形态再次演进。如果外挂记忆和缓存压缩进一步普及,跑量芯片未来连垂直打通堆叠都不再需要,做成单层封装的 0Hi 芯片就能满足大部分推理需求,也不是无可能。
过去两年,整个行业习惯了用最昂贵的显存硬扛所有负载。Engram 与 4-hi HBM撕开的突破口,让算法开始反过来给硬件做减法。在少数冲顶的赛车之外,把每一分钱与每一字节带宽都算到极致的工程理性,才是大模型真正走进普及和商业化落地的必然选择。